电商用户行为分析与 RFM 价值分层体系搭建
基于 1000 条电商用户全维度行为数据,用 SQL(SQLite)+ Python 完成用户全景画像、行为深度分析、RFM 价值分层与消费驱动因素挖掘,输出分群运营策略;并对参考项目中无法在本数据复现的结论逐条纠偏(AOV 相关 0.967 → 实测 0.0967)。
31.3%
高价值+流失高价值 GMV
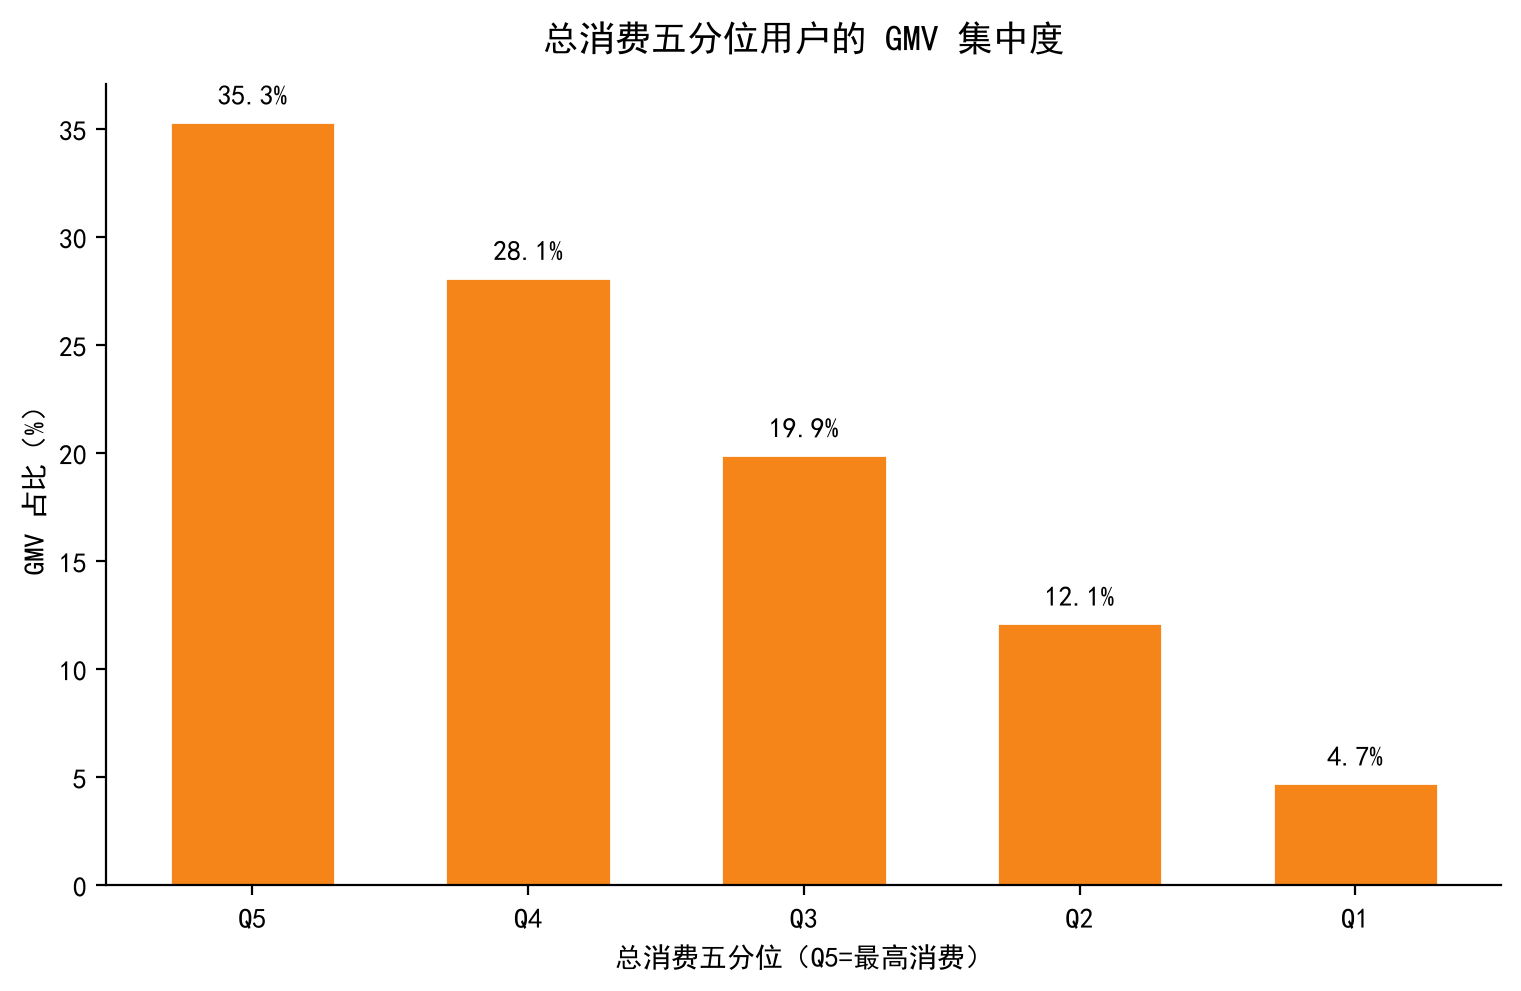
35.3%
消费 TOP20% GMV 占比
18 / 14
SQL 查询 / 图表
项目背景
电商行业获客成本持续攀升,粗放式运营已无法支撑平台长期增长。平台面临「用户画像模糊、价值分层不清晰、运营策略无差别、资源投入 ROI 低」的痛点:无法精准定位高价值用户,也无法针对性解决流失问题。
目标:用 1000 条用户属性 + 行为 + 消费数据,完成「用户全景画像 → 行为深度分析 → RFM 价值分层 → 消费驱动因素挖掘」,输出分群体、可落地的运营策略。
数据与指标口径
数据:user_personalized_features.csv,1000 条样本、14 个有效字段,覆盖用户属性(性别/年龄/地域/兴趣/收入)、行为特征(登录天数/停留时长/浏览页数/邮件订阅)、消费特征(购买频率/平均订单价值/总消费/品类偏好)。
流程:ETL 装载进 SQLite → 18 个 SQL 查询完成全部聚合(数据审计 / 画像分布 / 活跃度 / RFM 打分分段 / GMV 集中度)→ Python 统计层做相关分析与显著性检验 → matplotlib 14 张图 → 自包含 HTML 报告。
- 完整性0 缺失(SQL 审计)
- 重复性0 完全重复行
- 逻辑校验无负值;年龄 18–64 岁、登录天数 1–29 天均合理
- 参考项目结论「剔除 2 条重复 + 1 条负消费」「18% 用户超 30 天未登录」在本数据中均不存在,已按实测纠偏
用户全景画像
人口属性:男女 52.6% / 47.4% 结构均衡;36–55 岁核心用户合计 45.4% 是营收主力,18–25 岁仅 15.4% 是增长缺口;各年龄层平均消费均在 2,500 元上下,无年龄消费壁垒。
地域与偏好:下沉市场(郊区+农村)占 65.6% 是基本盘;兴趣 TOP 为 Sports / Fashion / Travel / Food,品类偏好 TOP 为 Apparel / Electronics / Books——兴趣与品类高度匹配,为场景化推荐提供依据。
行为深度分析
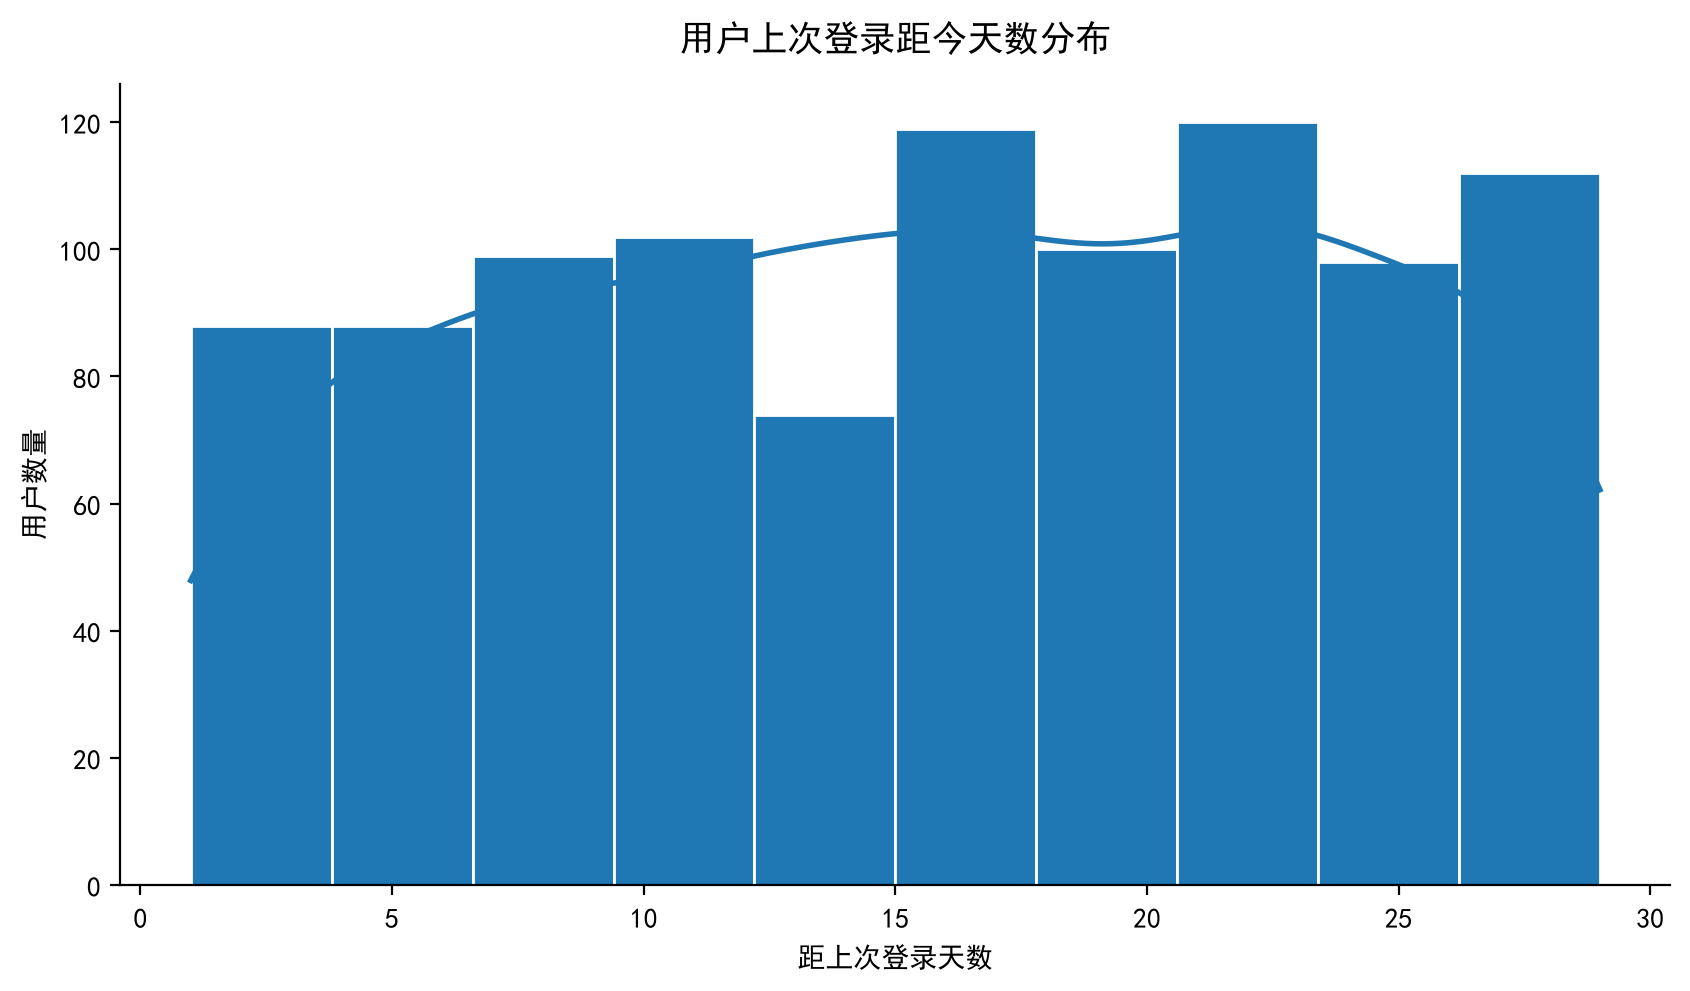
活跃度:高活跃(1–7 天)+ 活跃(8–15 天)合计 49.0%,另有 51.0% 用户处于「活跃下滑 / 流失高风险」(16–29 天),留存压力大,需重点召回。
粘性验证:邮件订阅用户停留中位数 300 分钟 vs 非订阅 288 分钟,略高但 Mann-Whitney U 检验 p=0.54 未达显著——参考项目「订阅显著提升粘性」结论在本数据上缺乏统计支持,建议作为低成本留存实验做 A/B 验证。
RFM 价值分层
RFM 口径:R=最近登录天数(倒序打分)、F=购买频率、M=总消费;用 SQL 窗口函数 NTILE(5) 等频五等分打分,再按经典 8 分法分群——打分逻辑完全落在数据库层,比 pandas qcut 更接近生产实现。
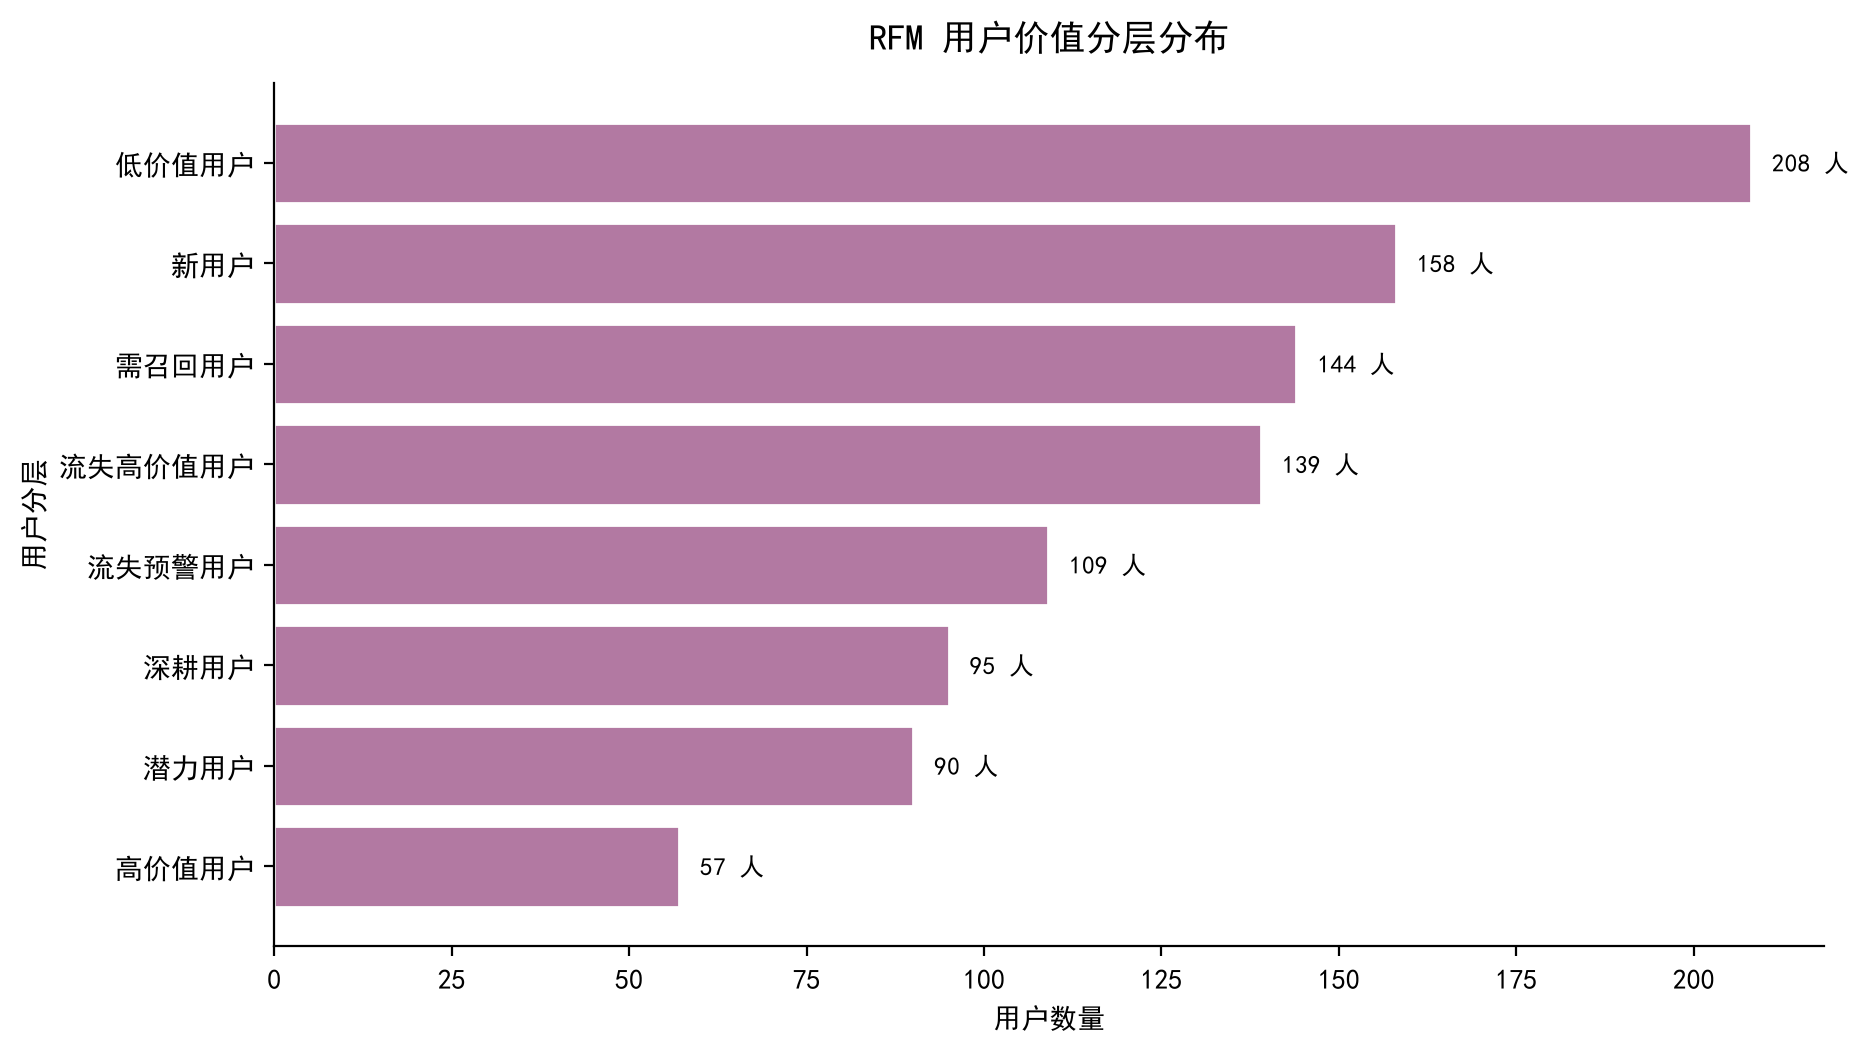
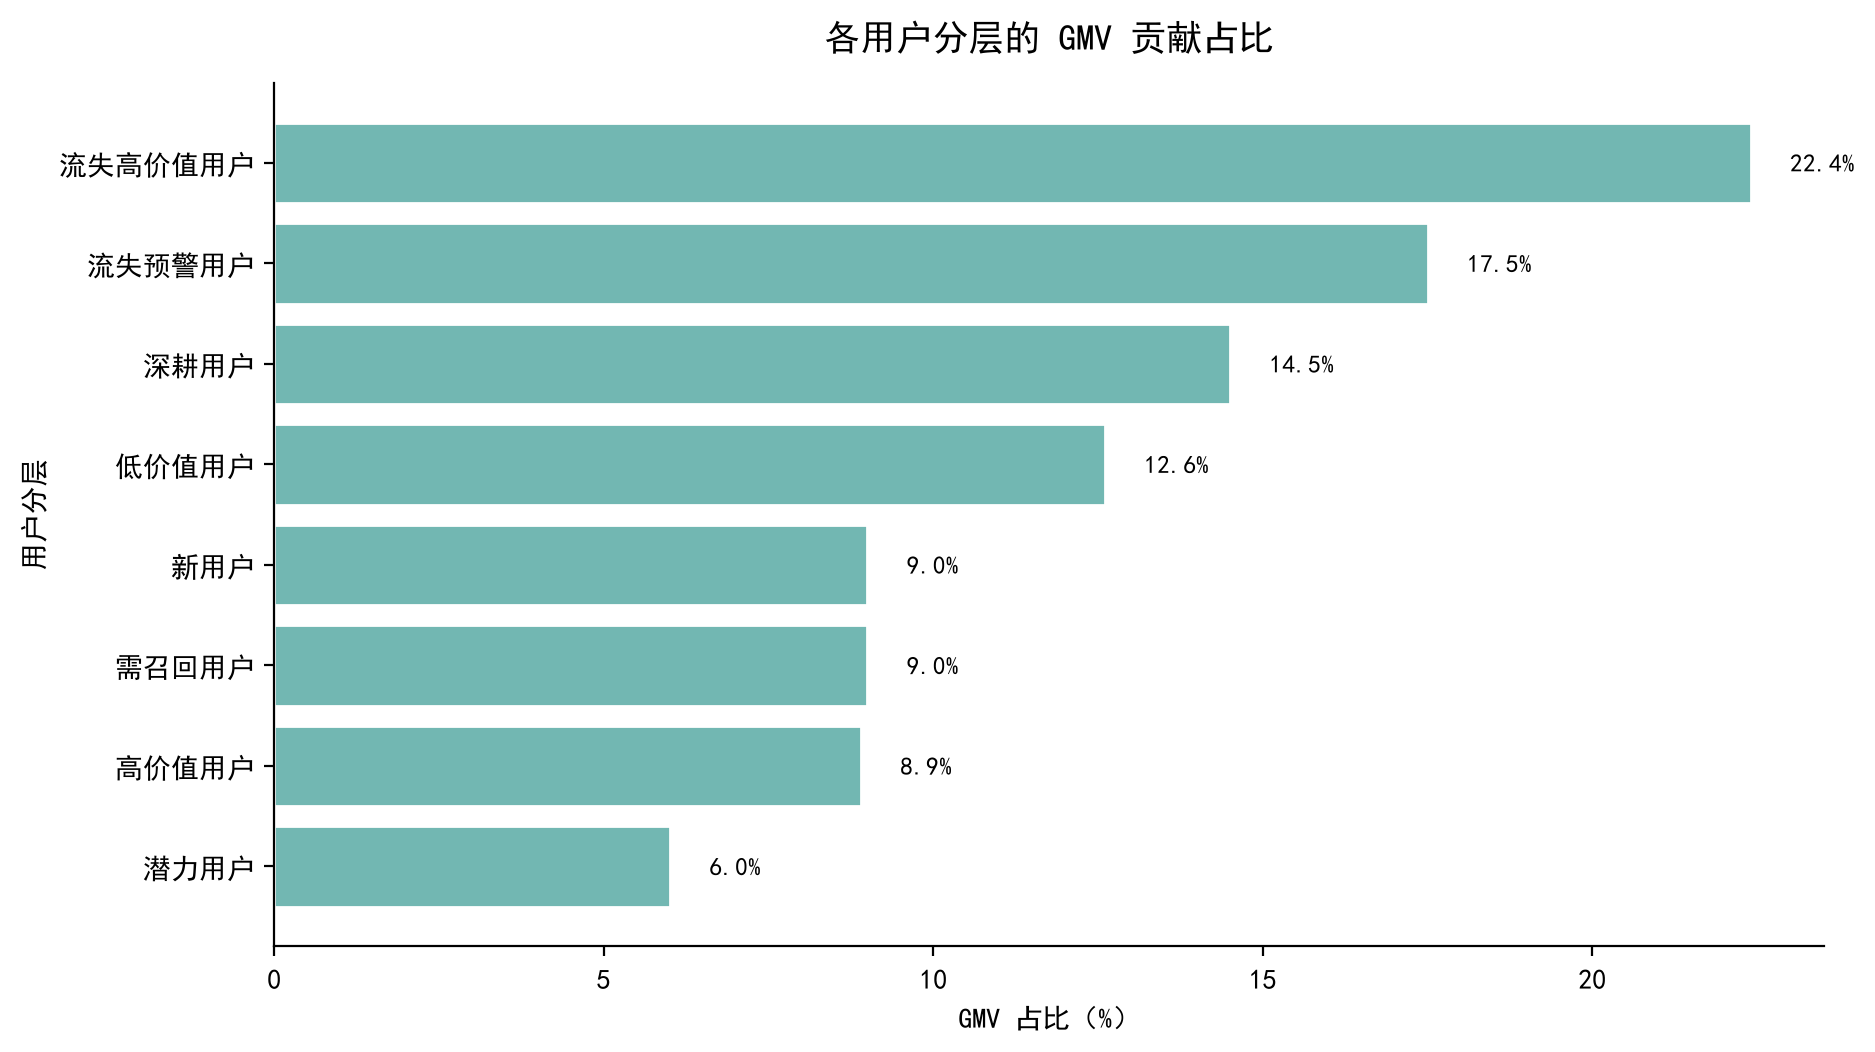
核心发现:高价值用户 57 人(5.7%)贡献 8.9% GMV;高价值 + 深耕 + 流失预警 + 流失高价值四群合计贡献 63.3% GMV;其中「流失高价值用户」(139 人)贡献 22.4% GMV,是平台最大的 GMV 池——先召回再拉新。
消费驱动因素(含纠偏)
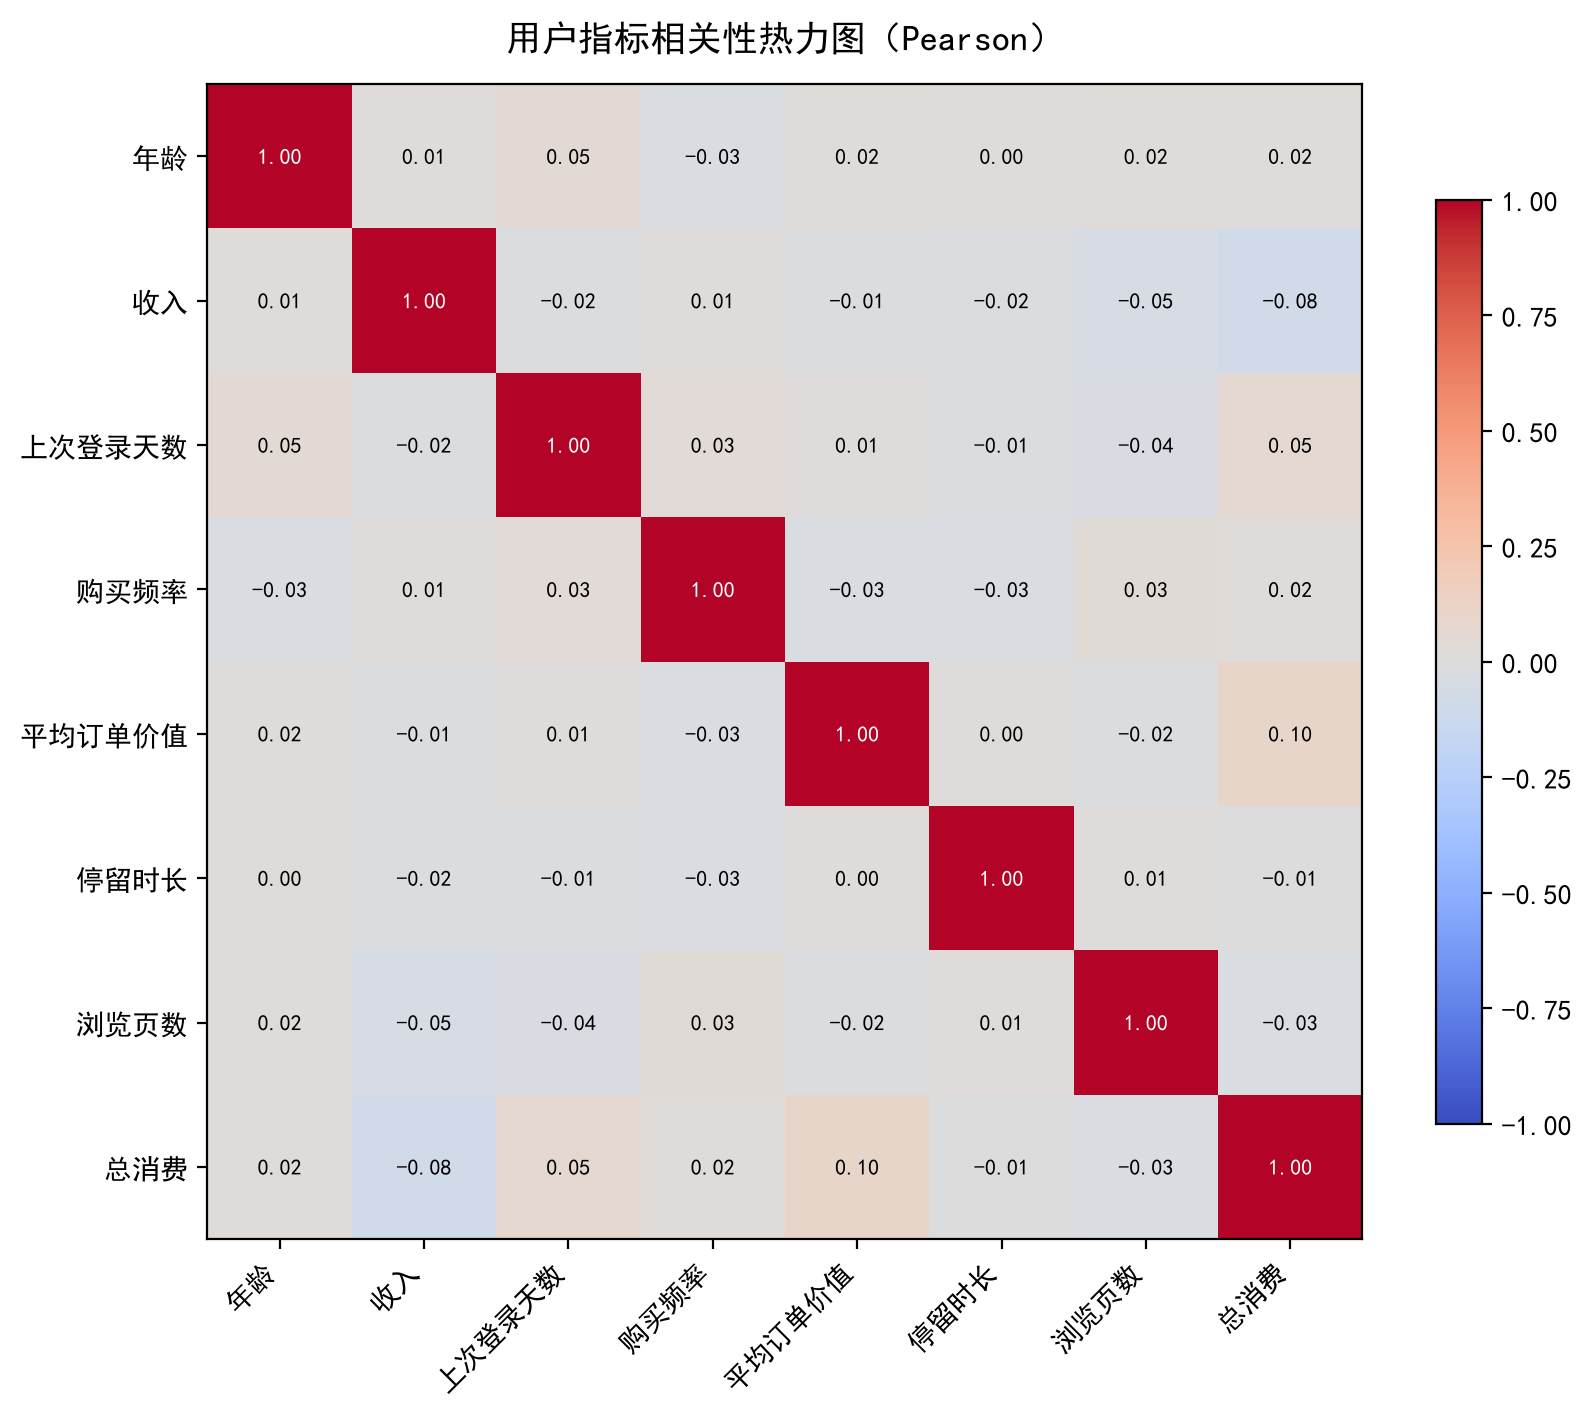
实测相关性:与总消费相关最高的仍是平均订单价值,但 Pearson r 仅 0.0967(Spearman ≈0.097)——参考项目结论「0.967 极强正相关」在本数据上不成立(应为笔误,社区评论亦曾指出)。现有字段对总消费的线性解释力有限。
补充验证:消费 TOP20% 用户贡献 35.3% GMV(约为底部五分之一用户的 7.5 倍),消费价值高度集中;而 AOV TOP20% 用户仅贡献约 21.6%(接近均等 20%)——单靠客单价无法解释消费差异,需补充订单明细与行为序列数据。
分类维度:收入层 × 总消费差异显著(Kruskal-Wallis p=0.029,低收入用户平均消费 2,742 元 > 高收入 2,447 元);年龄层、地域、品类偏好差异不显著。
结论边界(哪些结论不能证明)
SQL 全量计算 + 统计检验能证明分层与相关结构,但数据本身有明确边界,以下结论不能过度解读:
能证明
- RFM 分层与 GMV 池分布(SQL 全量计算,无抽样)
- AOV 与总消费相关性弱(Pearson / Spearman 双检验)
- 收入层消费差异显著(Kruskal-Wallis p=0.029)
不能证明
- 「AOV 与消费强相关 0.967」(实测 0.0967,系参考项目笔误)
- 邮件订阅提升留存 / 粘性(p=0.54 不显著)
- 时间维度结论(无订单明细与时间戳字段)
落地建议
以「高价值 + 流失高价值」为 GMV 核心资产(合计 31.3%)先做召回再拉新:高价值用户走 VIP 专属权益防流失,流失高价值用户用专属挽回包 + 1v1 触达优先召回;流失预警用户 Push+短信组合立即唤醒。
增长动作:潜力用户向上引导客单价(满减/升级推荐)、新用户首单转化券完成 0→1、需召回用户批量触达(站内信+邮件)、低价值用户控制投入用自动化旅程低成本维系。
数据建议:把邮件订阅做成 A/B 实验验证留存价值;针对 18–25 岁补增长缺口;补充订单明细与点击行为序列,升级为可解释的消费预测模型。
- 短期召回流失高价值 139 人专属挽回包 + 1v1 触达;流失预警 109 人 Push+短信立即唤醒
- 中期增长潜力用户提客单价(满减/升级推荐)、新用户首单券、18-25 岁补缺口、订阅 A/B 实验
- 长期升级补订单明细与点击行为序列,升级为可解释的消费预测模型
实验设计(如果再做一次)
订阅组与对照组差异不显著(p=0.54),为把「订阅值得做」从推断变成证据,设计一次可执行的 A/B 实验:
技术栈
- SQL
- SQLite
- Python
- Pandas
- 统计检验
- matplotlib